로지스틱 회귀 3편: 학습 종료
완벽히 나뉘는 데이터에서 w가 끝없이 커지는 현상을 데이터 6개로 확인하고, L2 정규화와 조기 중단, 시리즈 전체 체크리스트를 정리했다.
이 글의 코드와 수치는 노트북으로 직접 실행해 볼 수 있다.
노트북 내려받기2편에서 경사 하강법으로 w와 b를 학습했다. 이 글은 마지막 단계인 학습 종료, 즉 “언제 멈출 것인가”를 다룬다. 데이터는 1·2편과 같은 공부시간 6개다.
| 공부시간 x | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| 합격 여부 y | 0 | 0 | 0 | 1 | 1 | 1 |
6단계 학습 종료: 오래 학습할수록 w는 끝없이 커진다
한 줄 요약: 데이터가 완벽하게 나뉘면 손실을 0으로 보내려고 w가 멈추지 않고 커지고, 확률은 0과 1로 극단화된다. 학습 정확도로는 이 변화가 보이지 않는다. 정규화나 조기 중단으로 멈춰야 한다.
중요한 것: 정확도 100%는 학습이 끝났다는 뜻이 아니다
학습률 0.1로 1,000 에포크 학습한 모델은 학습 데이터 6개를 모두 맞힌다([0 0 0 1 1 1]). 사실 정확도 100%는 243 에포크에서 이미 달성됐다. 그 뒤로도 평균 손실은 0.2988에서 0.1516까지 한 번도 늘지 않고 계속 줄었다. 정확도는 “임계값의 어느 쪽에 있나”만 세고, 손실은 정답에 준 확률까지 잰다. 이 둘이 갈라지는 지점에서 로지스틱 회귀의 가장 큰 함정이 나온다.
주의할 점: 완벽히 나뉘는 데이터에서는 w에 끝이 없다
같은 설정(학습률 0.1, 초기값 0)으로 100만 에포크까지 학습하면 다음과 같다.
| 에포크 | w | b | 결정 경계 -b/w |
평균 손실 | p(x=3) | p(x=4) |
|---|---|---|---|---|---|---|
| 1,000 | 1.7036 | -5.6903 | 3.3401 | 0.151639 | 0.359056 | 0.754757 |
| 10,000 | 4.1539 | -14.3839 | 3.4628 | 0.040422 | 0.127611 | 0.903055 |
| 100,000 | 8.2965 | -28.9029 | 3.4837 | 0.005271 | 0.017754 | 0.986391 |
| 1,000,000 | 12.8979 | -45.0097 | 3.4897 | 0.000532 | 0.001804 | 0.998617 |
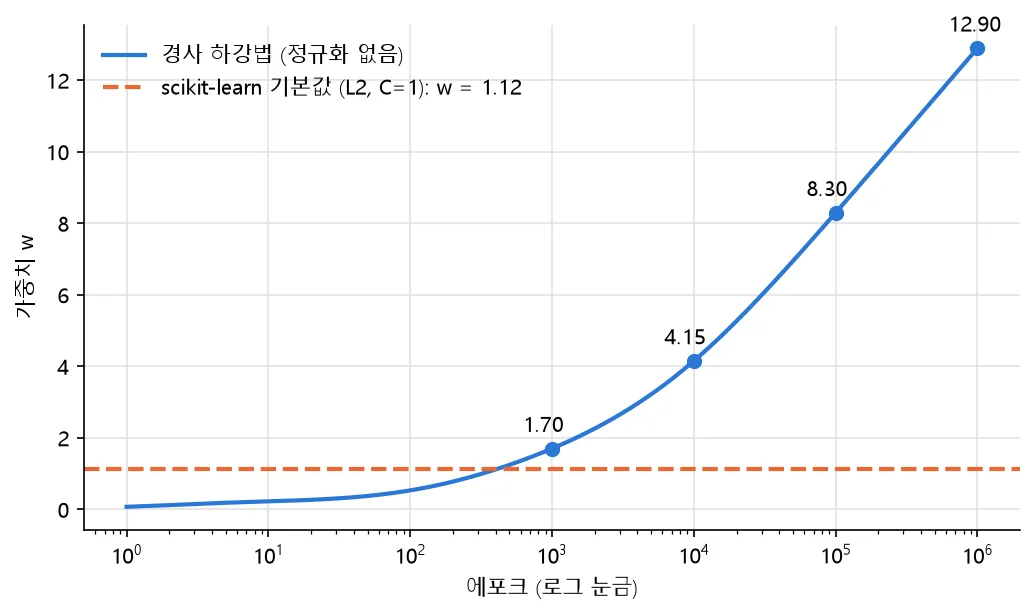
에포크를 10배 늘릴 때마다 w가 2.45, 4.14, 4.60씩 커진다. 100만 에포크까지는 멈추는 기미가 없다. 그 사이 결정 경계 -b/w는 3.34에서 3.49로 데이터의 한가운데인 3.5에 다가가고, 손실은 0에 다가간다.
왜 멈추지 않나. 이 데이터는 3시간과 4시간 사이에 선을 그으면 6개가 모두 정확히 나뉜다. 이렇게 직선 하나로 두 클래스가 오차 없이 나뉘는 상태를 영어로 complete separation이라고 부른다. 모두 맞힌 상태에서 w와 b를 같은 비율로 키우면 경계(-b/w)는 그대로인데, 모든 샘플의 z가 0에서 더 멀어진다. 그러면 모든 샘플의 확률이 정답 쪽으로 더 가까워져서 손실이 더 줄어든다. 1,000 에포크 결과에 배수를 곱하면 다음과 같다.
c = 1: w =  1.7036, b =  -5.6903, -b/w = 3.3401, mean loss = 0.151639
c = 2: w =  3.4072, b = -11.3806, -b/w = 3.3401, mean loss = 0.064601
c = 4: w =  6.8144, b = -22.7612, -b/w = 3.3401, mean loss = 0.017523
c = 8: w = 13.6289, b = -45.5224, -b/w = 3.3401, mean loss = 0.001629
경계는 그대로이고 손실만 줄어든다. 키울수록 계속 좋아지니 손실을 최소로 만드는 유한한 w가 없다. 영어 위키백과도 이 상태를 “모든 사례가 정확히 분류되고, 계수가 무한대일 때 가능도가 최대가 되는 경우”로 설명하며, 반복 계산이 수렴하지 못하는 원인으로 든다. 경사 하강법의 w가 계속 커진 이유가 이것이다. 다만 커지는 속도는 점점 느려진다.
무엇이 문제인가. 경계가 3.5 근처로 맞아 가니 괜찮아 보일 수 있다. 문제는 확률이다. 아래 그래프에서 100,000 에포크 모델은 3시간 공부한 학생의 합격 확률을 0.018로, 4시간 공부한 학생의 합격 확률을 0.986으로 예측한다. 3시간과 4시간 사이에는 데이터가 하나도 없는데, 그 1시간 사이에서 확률이 거의 0에서 거의 1로 뛴다. 데이터 6개로는 뒷받침할 수 없는 극단적인 확률이다.
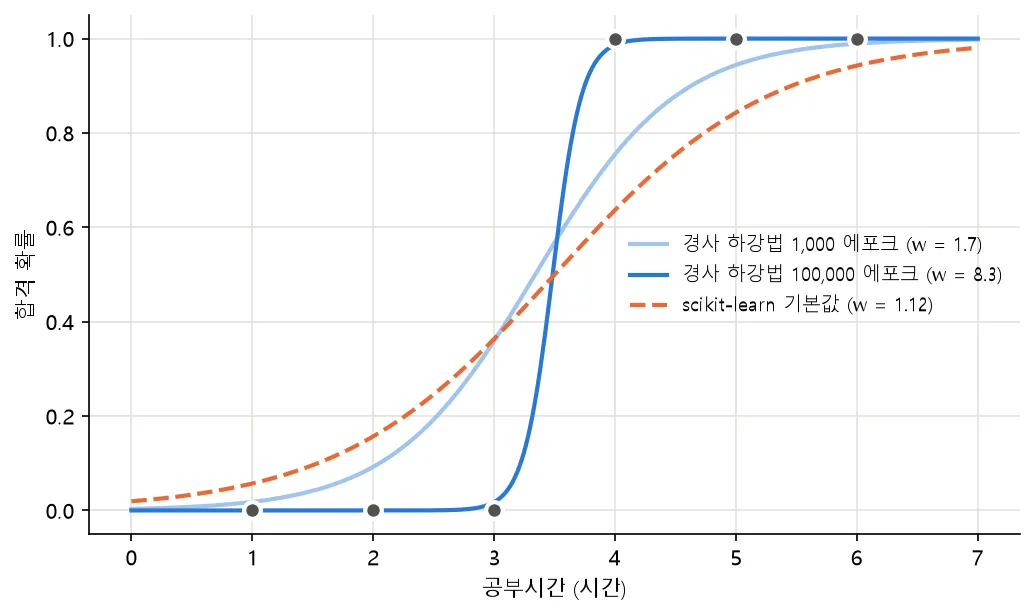
Google 머신러닝 단기집중과정도 정규화가 로지스틱 회귀에서 “매우 중요하다”며 같은 현상을 경고한다. 정규화가 없으면 로지스틱 회귀의 점근적 성질 때문에 손실이 계속 0으로 간다는 설명이다. 이 문서는 특성(feature)이 많은 경우를 예로 든다. 이 글의 데이터는 특성이 공부시간 하나뿐인데도 같은 일이 일어났다. 데이터가 완벽히 나뉘어 있기 때문이라고 본다(내 해석).
대책 1: L2 정규화로 w를 붙잡는다
여기서 정규화(regularization)는 모델이 지나치게 커지는 것을 막으려고 손실에 벌점을 더하는 기법이다. 입력값의 범위를 맞추는 정규화(normalization)와는 다른 개념이다. 이름이 같아서 헷갈리기 쉽다.
L2 정규화는 손실에 w의 제곱에 비례하는 벌점을 더한다. w를 키우면 로그 손실은 줄지만 벌점이 늘어나므로, 둘이 균형을 이루는 지점에서 w가 멈춘다. scikit-learn 문서에 적힌 이진 로지스틱 회귀의 목적 함수를 텍스트로 옮기면 다음과 같다(샘플 가중치가 모두 1일 때).
minimize mean( 로그 손실 ) + (1/2)·w² / (n·C)여기서 n은 샘플 수다. C는 정규화 강도의 역수라서 C가 작을수록 정규화가 강하다. 같은 문서에 따르면 lbfgs 같은 기본 solver는 절편 b에는 벌점을 주지 않는다.
LogisticRegression()은 기본으로 L2 정규화를 건다. scikit-learn 1.9.1의 기본 파라미터는 C=1.0, l1_ratio=0.0이다. 원래 정규화 종류를 정하던 penalty 파라미터는 1.8에서 사용 중단이 예고되었고(deprecated) 1.10에서 제거될 예정이다. 지금은 l1_ratio=0이 L2를 뜻한다. 예전 글에서 흔히 보이는 LogisticRegression(penalty='l2')는 1.9.1에서 같은 결과(w=1.1207)를 내지만 FutureWarning을 띄운다. 1.10부터는 동작하지 않을 것이다.
같은 6개 데이터로 C만 바꾸면 다음과 같다.
| C | w | b | 결정 경계 -b/w |
p(3.5) | 학습 정확도 |
|---|---|---|---|---|---|
| 1.0 | 1.1207 | -3.9223 | 3.4999 | 0.5000 | 1.0 |
| 100.0 | 5.6523 | -19.7832 | 3.5000 | 0.5000 | 1.0 |
| 1,000,000 | 15.1558 | -52.7585 | 3.4811 | 0.5712 | 1.0 |
기본값 C=1에서는 w가 1.12에서 멈추고, 경계는 3.4999로 데이터 한가운데인 3.5에 놓인다. C를 키워 정규화를 약하게 하면 w가 커진다. C=1e6은 정규화가 매우 약한 상태다(문서에 따르면 정규화를 완전히 끄려면 C=np.inf).
C=1e6에서 경계가 3.5를 벗어나 3.48이 되는 것은 solver가 일찍 멈췄기 때문이다. solver를 더 오래 돌리도록 max_iter=10000, tol=1e-10을 주면 w=21.50, 경계 3.5000이 나온다. 기본 설정(tol=1e-4)에서는 17번 반복하고 멈췄으니, 반복 횟수 한도가 아니라 허용 오차 기준에서 일찍 멈춘 것이다. 정규화가 거의 없으면 w가 계속 커지려 하니 “어디서 멈추느냐”가 결과를 정한다. 경사 하강법에서 본 것과 같은 현상이다.
대책 2: 조기 중단
Google 단기집중과정은 L2 정규화와 함께 조기 중단(early stopping)을 대책으로 든다. 손실이 아직 줄고 있을 때 학습 단계 수를 제한해 멈추는 방법이다. 1·2편의 경사 하강법도 1,000 에포크에서 멈췄기 때문에 w=1.70에 머물렀다. 하지만 언제 멈출지는 보통 학습에 쓰지 않은 검증 데이터의 손실을 보고 정한다. 6개뿐인 이 데이터로는 검증 데이터를 따로 떼어 낼 수 없어서 실험하지 않았다.
시리즈 정리: 단계별 체크리스트
세 편에서 6개 데이터로 본 것을 단계별로 모으면 다음과 같다.
| 단계 | 중요한 것 | 주의할 점 | 확인한 근거 |
|---|---|---|---|
| 1편 선형식 | z = w·x + b는 확률이 아닌 점수(로짓) | 선형 회귀를 그대로 쓰면 0~1을 벗어남 | OLS 직선: x=1 → -0.143, x=6 → 1.143 |
| 1편 시그모이드 | 어떤 z든 0~1로 압축, z=0 → 0.5 | 양 끝은 기울기가 거의 0이고, float64에서는 정확히 1.0이 됨 | z=37부터 sigmoid = 1.0 |
| 1편 임계값 | w, b와 함께 학습되지 않고 따로 정함(직접 또는 검증 지표로 조정) | 0.5는 관례. 경계 근처 판정은 모델마다 다름 | 3.5시간: 0.568 vs 0.50003 |
| 2편 로그 손실 | 정답에 낮은 확률을 줄수록 상한 없이 벌함 | MSE는 크게 틀린 쪽에서 기울기가 작아짐. 확률 0/1이면 inf, NaN | p=0.01에서 기울기 크기 0.0196 vs 0.99, 0 × -inf = NaN |
| 2편 경사 하강법 | 기울기 = 오차 × 입력 | 평균 손실로 추세를 보고 경계 근처 샘플은 따로 봄. 에포크 수는 학습률과 묶어 정함 | 수치 미분과 10자리 일치, 학습률 0.01은 1,000 에포크 후에도 x=3 오분류 |
| 3편 학습 종료 | 정확도 100%는 끝이 아님 | 완벽히 나뉘는 데이터면 w가 끝없이 커짐 → 정규화, 조기 중단 | 100만 에포크 w=12.90 vs scikit-learn C=1 w=1.12 |
이 글에서 다루지 않는 것
데이터가 특성 하나, 샘플 6개라서 확인하지 못한 것이 많다. 아래 항목은 확인하지 않았다.
- 클래스가 겹치는 데이터에서의 학습률: 학습률 비교는 완벽히 나뉘는 이 데이터에서만 했다. 큰 학습률이 발산하는 경우는 이 데이터로 재현하지 못했다.
- 특성이 여러 개일 때: 특성 사이 크기 차이(스케일)가 경사 하강법에 주는 영향과 특성 스케일링은 다루지 않았다.
- 완벽히 나뉘지 않는 데이터: 클래스가 겹쳐도 일부 구간이 완벽히 나뉘면(준완전 분리, quasi-complete separation) w가 발산할 수 있다. 완전 분리와 준완전 분리가 모두 없으면 정규화 없이도 유한한 해가 있을 수 있지만, 경사 하강법이 거기에 수렴하는지는 학습률 등에도 달려 있다. 이 글에서는 이런 데이터의 학습을 확인하지 않았다.
- 임계값을 고르는 방법: 정밀도, 재현율, ROC 곡선 등은 다루지 않았다.
- 클래스 불균형, 다중 클래스 분류
- 검증 데이터를 이용한 조기 중단
참고 자료
- Google, 머신러닝 용어집
- Google, Machine Learning Crash Course: Logistic regression: Loss and regularization, Thresholds and the confusion matrix
- scikit-learn 1.9.1 문서:
LogisticRegression, Logistic regression 사용자 가이드,log_loss - 위키백과: Logistic regression(영어), 교차 엔트로피(한국어)
부록: 용어 대조표
이 시리즈에서 쓴 핵심 용어의 한국어 표기와 영어 원어다. 한국어 표기는 Google 머신러닝 용어집 한국어판과 한국어 위키백과 표제어를 대조해 골랐다. 출처마다 번역이 다른 용어는 “다른 표기”에 함께 적었다.
| 이 시리즈의 표기 | 영어 | 다른 표기 / 비고 |
|---|---|---|
| 로지스틱 회귀 | logistic regression | 이름은 회귀지만 분류 모델 |
| 이진 분류 | binary classification | |
| 선형 회귀 | linear regression | |
| 최소제곱법 | (ordinary) least squares, OLS | |
| 가중치 | weight | Google 용어집 한국어판 표제어는 “무게”(본문 링크에는 “가중치”) |
| 편향 | bias | 편향 항 |
| 로짓 | logit | z = w·x + b |
| 로그 오즈 | log-odds | log(p / (1 - p)), 로짓과 같은 값 |
| 시그모이드 함수 | sigmoid function | S자 곡선 함수의 총칭. 이 시리즈의 1 / (1 + e^(-z))는 그중 로지스틱 함수(logistic function) |
| 임계값 | (classification) threshold | Google 용어집: 분류 기준점 |
| 결정 경계 | decision boundary | 이 시리즈의 데이터에서는 x = -b/w |
| 손실 함수 | loss function | 비용 함수(cost function) |
| 로그 손실 | log loss | 이진 교차 엔트로피(binary cross-entropy) |
| 교차 엔트로피 | cross-entropy | 로그 손실을 다중 클래스로 일반화한 것 |
| 평균 제곱 오차 | mean squared error, MSE | 제곱 손실(squared loss), L2 손실 |
| 경사 하강법 | gradient descent | 경사하강법(붙여 씀) |
| 기울기 | gradient | 그래디언트 |
| 학습률 | learning rate | |
| 에포크 | epoch | |
| (완벽히 나뉘는 데이터) | complete separation | 직선 하나로 두 클래스가 오차 없이 나뉘는 상태. 선형 분리 가능(linearly separable)이라고도 한다. 확인된 한국어 용어가 없어 본문에서는 풀어 썼다 |
| 정규화 | regularization | 정칙화(위키백과), 규제(출처로 확인하지 못함). 입력 스케일을 맞추는 정규화(normalization)와 다른 개념 |
| L2 정규화 | L2 regularization | |
| 조기 중단 | early stopping | |
| NaN | Not a Number | NumPy 출력은 nan |