로지스틱 회귀 2편: 학습
로지스틱 회귀의 학습 단계(로그 손실, 경사 하강법)를 데이터 6개로 실행하고, 손실 선택과 clip, 기울기, 학습률에서 주의할 점을 정리했다.
이 글의 코드와 수치는 노트북으로 직접 실행해 볼 수 있다.
노트북 내려받기1편에서 공부시간 6개 데이터로 확률을 만드는 단계(선형식, 시그모이드, 임계값)를 봤다. 이 글은 모델이 w와 b를 찾는 학습 단계, 즉 로그 손실과 경사 하강법을 다룬다. 데이터는 1편과 같다.
| 공부시간 x | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| 합격 여부 y | 0 | 0 | 0 | 1 | 1 | 1 |
4단계 로그 손실: 정답에 낮은 확률을 줄수록 더 세게 벌한다
한 줄 요약: 정답에 낮은 확률을 줄수록 로그 손실은 끝없이 커진다. 평균 제곱 오차(MSE)로 바꾸면 크게 틀린 쪽에서 더 틀릴수록 기울기가 작아져 잘 고쳐지지 않는다. 확률이 정확히 0이나 1이 되면 계산이 inf나 NaN으로 깨지므로 clip이 필요하다.
중요한 것: 틀렸는지가 아니라 정답에 준 확률을 본다
샘플 하나의 로그 손실(log loss)은 다음과 같다.1
loss = -( y·log(p) + (1 - y)·log(1 - p) )

정답 y = 1 이면  loss = -log(p)        p가 1에 가까울수록 0
정답 y = 0 이면  loss = -log(1 - p)    p가 0에 가까울수록 0
학습에서 줄이는 값은 이 손실의 전체 샘플 평균이다.
정답이 1일 때 예측 확률 p에 따른 로그 손실과 제곱 오차 (1 - p)²를 나란히 그렸다.
| 예측 p (정답 1) | 로그 손실 -log(p) |
제곱 오차 (1 - p)² |
|---|---|---|
| 0.99 | 0.0101 | 0.0001 |
| 0.9 | 0.1054 | 0.0100 |
| 0.5 | 0.6931 | 0.2500 |
| 0.1 | 2.3026 | 0.8100 |
| 0.01 | 4.6052 | 0.9801 |
| 0.001 | 6.9078 | 0.9980 |
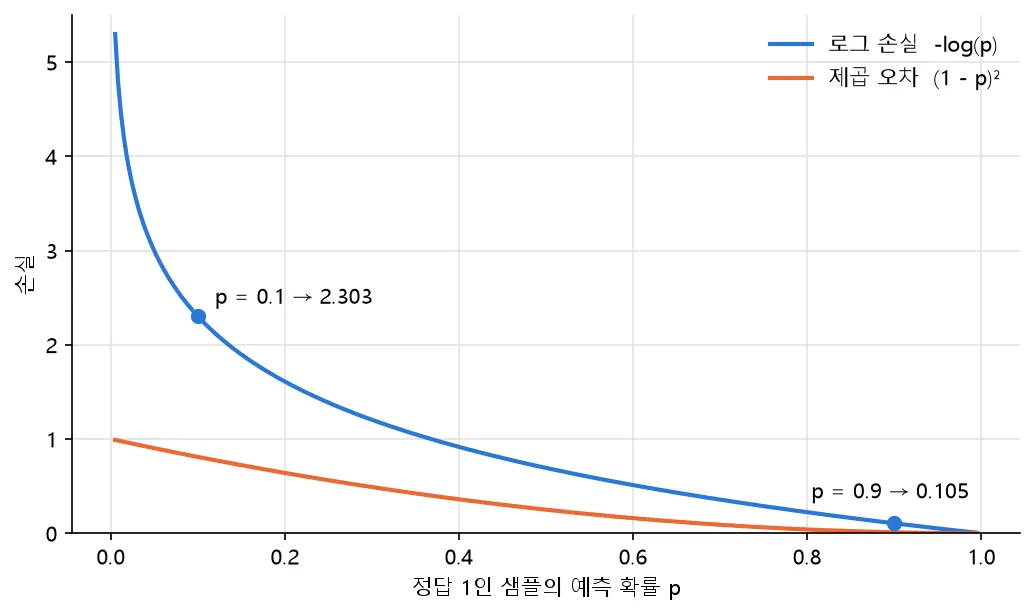
정답이 1인데 0.9로 예측하면 손실은 0.105, 0.1로 예측하면 2.303으로 약 22배다. 핵심은 표의 아래쪽이다. 제곱 오차는 p가 0으로 가도 1을 넘지 못한다. 반면 로그 손실은 0.01에서 4.6, 0.001에서 6.9로 계속 커진다. 정답에 0.1%만 준 예측에는 상한 없이 큰 벌점을 준다.
주의할 점 1: MSE를 쓰면 크게 틀린 쪽에서 기울기가 작아진다
손실 값의 크기만 보면 “제곱 오차도 p가 작을수록 커지니 비슷한 것 아닌가”라는 생각이 든다. 학습에서 중요한 것은 손실 값이 아니라 기울기다. 경사 하강법은 기울기만큼 w와 b를 움직이기 때문이다.
z에 대한 기울기를 연쇄 법칙으로 구하면 1편에서 본 시그모이드의 미분 p·(1 - p)가 곱해진다.
dloss/dz = dloss/dp × dp/dz
dp/dz    = p·(1 - p)        (시그모이드의 미분, 1편)

제곱 오차:
  dloss/dz = 2(p - y) × p·(1 - p)

로그 손실:
  dloss/dz = ( -y/p + (1 - y)/(1 - p) ) × p·(1 - p)
           = p - y
로그 손실을 p로 미분하면 나오는 1/p, 1/(1 - p)가 시그모이드의 미분 p·(1 - p)와 곱해지면서 정확히 상쇄된다. 남는 것은 p - y, 즉 “예측과 정답의 차이”다. 제곱 오차는 p·(1 - p)가 그대로 남는다. 정답이 1인 샘플에서 두 기울기를 계산하면 다음과 같다.
| 예측 p (정답 1) | 제곱 오차의 기울기 | 로그 손실의 기울기 |
|---|---|---|
| 0.01 | -0.0196 | -0.99 |
| 0.1 | -0.162 | -0.9 |
| 0.5 | -0.25 | -0.5 |
| 0.9 | -0.018 | -0.1 |
| 0.99 | -0.0002 | -0.01 |
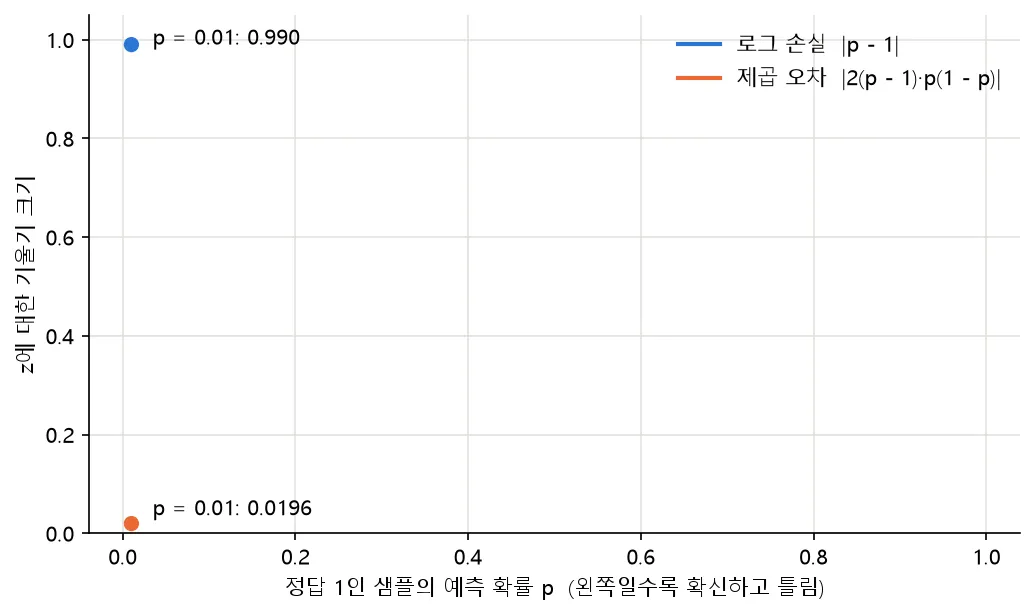
p=0.01, 즉 정답에 0.01만 준 샘플에서 제곱 오차의 기울기 크기는 0.0196이다. 로그 손실의 기울기 크기 0.99보다 약 50배 작다. 그래프를 보면 문제가 더 분명하다. 제곱 오차의 기울기 크기는 p가 약 0.33일 때 최대(약 0.296)이고, 그보다 더 틀릴수록 오히려 작아진다. 크게 틀린 샘플일수록 시그모이드의 평평한 구간에 갇혀 덜 수정되는 셈이다. 로그 손실은 틀린 만큼 기울기 크기가 커진다.
Google 머신러닝 단기집중과정은 같은 결론을 다른 각도에서 설명한다. 제곱 손실은 출력의 변화율이 일정한 선형 모델에 잘 맞는다. 로지스틱 회귀는 출력이 0이나 1에 가까워질수록 변화율이 달라지기 때문에 로그 손실을 쓴다는 설명이다.
이 비교는 샘플 하나에서 기울기를 계산한 것이다. 제곱 오차로 실제 모델을 학습해 결과를 비교하지는 않았다.
주의할 점 2: 확률이 정확히 0이나 1이면 inf와 NaN이 나온다
1편에서 float64의 시그모이드는 z가 37 정도만 돼도 정확히 1.0이 된다고 했다. 그런 값이 clip 없이 로그 손실에 들어가면 이렇게 된다. 함께 나오는 경고도 모아 찍었다.
def log_loss_noclip(y, p):
    return -(y * np.log(p) + (1 - y) * np.log(1 - p))

with warnings.catch_warnings(record=True) as caught:
    warnings.simplefilter('always')
    print(log_loss_noclip(1.0, 0.0))
    print(log_loss_noclip(0.0, 0.0))
    print(log_loss_noclip(0.0, sigmoid(40.0)))
for msg in dict.fromkeys(f'{w_.category.__name__}: {w_.message}' for w_ in caught):
print(msg)inf
nan
inf
RuntimeWarning: divide by zero encountered in log
RuntimeWarning: invalid value encountered in scalar multiply- 정답 1에 확률 0:
log(0) = -inf라서 손실이inf다. 수학적으로도 무한대니 이상하지 않다. - 정답 0에 확률 0: 완벽하게 맞혔는데 NaN이 나온다. NumPy는 NaN을
nan으로 출력한다. 정답이 0이라y·log(p)항은 0이어야 하지만,log(0) = -inf이고0 × -inf는 NaN이다. 손실 하나가 NaN이면 평균 손실도 NaN이 되어 학습이 잘 되고 있는지 볼 수 없다. 이 글의 학습 코드는 기울기를p - y공식으로 따로 계산하기 때문에 w, b 업데이트 자체는 영향을 받지 않는다. 손실 값을 보고 학습을 멈추는 코드라면 이 NaN 때문에 판단이 깨진다.
그래서 로그를 취하기 전에 확률을 [eps, 1 - eps]로 자른다.
def log_loss_clip(y, p):
    eps = 1e-15
    p = np.clip(p, eps, 1 - eps)
    return -(y * np.log(p) + (1 - y) * np.log(1 - p))

print(log_loss_clip(1.0, 0.0))
print(log_loss_clip(0.0, 0.0))34.538776394910684
9.992007221626415e-16clip을 하면 손실 하나의 최댓값이 -log(1e-15) ≈ 34.54로 제한되고, 정답 0에 확률 0인 경우도 NaN 대신 거의 0이 나온다. scikit-learn의 log_loss도 문서에 따르면 확률을 [eps, 1 - eps]로 자른다. 여기서 eps는 입력 dtype의 기계 정밀도다. sklearn.metrics.log_loss에 확률 0과 1을 그대로 넣으면 에러 없이 36.0437이 나온다. 이 값은 float64 기계 정밀도(약 2.22e-16)로 계산한 -log(eps)와 같다.
print(log_loss([1, 0], [0.0, 1.0], labels=[0, 1]))
print(-np.log(np.finfo(np.float64).eps))36.04365338911715
36.043653389117155단계 경사 하강법: 기울기가 (p - y)·x로 단순한 이유
한 줄 요약: 로그 손실과 시그모이드를 함께 미분하면 기울기는 “오차 × 입력”으로 정리된다. 공식으로 한 번에 풀 수 없어서 이 기울기를 따라 조금씩 반복해 움직인다. 학습이 잘 되는지는 샘플별 손실이 아니라 평균 손실로 본다. 학습률이 너무 작으면 정해진 에포크 안에 다 배우지 못하고, 크면 처음에 손실이 출렁인다.
중요한 것: 기울기는 오차 × 입력이다
앞에서 로그 손실을 z로 미분하면 p - y가 된다는 것을 봤다. z = w·x + b이니 w로 미분하면 x가 한 번 더 곱해지고, b로 미분하면 1이 곱해진다. 전체 샘플 평균을 내면 다음과 같다.
dw = mean( (p - y) · x )
db = mean( p - y )

w ← w - 학습률 × dw
b ← b - 학습률 × db
샘플마다 “얼마나 틀렸나(p - y)“에 “그 샘플의 입력 크기(x)“를 곱해 평균 낸 것이 w의 기울기다. 이 공식으로 구한 기울기를 수치 미분값과 비교하면 다음과 같다. 수치 미분값은 w, b를 아주 조금(1e-6) 움직여서 평균 손실이 변하는 비율을 직접 잰 값이다.
| (w, b) | dw 공식 | dw 수치 미분 | db 공식 | db 수치 미분 |
|---|---|---|---|---|
| (0, 0) | -0.7500000000 | -0.7499999999 | 0.0000000000 | 0.0000000000 |
| (0.5, -1.0) | 0.0903013043 | 0.0903013043 | 0.1549050221 | 0.1549050222 |
| (1.7036, -5.6903) | -0.0072859464 | -0.0072859464 | 0.0263422512 | 0.0263422512 |
소수점 아래 9~10자리까지 같다.
첫 업데이트를 손으로 따라가 보면 공식의 뜻이 보인다. w = b = 0에서 시작하면 모든 샘플의 z가 0이고 확률은 전부 0.5다.
p - y = [ 0.5  0.5  0.5 -0.5 -0.5 -0.5]
(p - y) · x = [ 0.5  1.0  1.5 -2.0 -2.5 -3.0]

dw = mean( (p - y) · x ) = -0.75
db = mean( p - y ) = 0

학습률 0.1:  w = 0 - 0.1 × (-0.75) = 0.075,  b = 0 - 0.1 × 0 = 0
코드로 한 번 업데이트해도 w = 0.075, b = 0이 나온다. 합격 쪽 샘플(x=4~6)의 입력이 더 커서 음의 기울기가 이기고, w가 양수 쪽으로 움직인다. “공부시간이 길수록 합격”이라는 방향을 첫걸음에 잡은 것이다.
왜 반복해야 하나
선형 회귀는 최소제곱법 공식으로 w, b를 한 번에 구한다(1편의 np.polyfit). 로지스틱 회귀는 그런 닫힌 형태의 해가 없다. 영어 위키백과는 “정규화를 쓰든 안 쓰든 보통 닫힌 형태의 해를 찾을 수 없어 반복적인 수치 방법을 써야 한다”고 적고 있다. scikit-learn의 로지스틱 회귀 문서도 lbfgs, newton-cg, saga 같은 반복 solver만 설명한다. 이 글의 경사 하강법은 그중 가장 단순한 방식이다.
주의할 점 1: 학습 상태는 평균 손실로 본다
학습 로그에 샘플 6개의 손실을 배열로 찍으면 학습이 나아지는지 한눈에 보기 어렵다. 경사 하강법이 줄이는 값은 평균 손실이니, 볼 값도 평균 손실이다. 학습률 0.1, 초기값 0으로 학습하며 평균 손실을 찍으면 다음과 같다.
epoch    0: mean 0.6931
epoch  100: mean 0.4213
epoch  200: mean 0.3252
epoch  300: mean 0.2714
epoch  500: mean 0.2128
epoch 1000: mean 0.1516
평균 손실은 1,000 에포크 동안 매 에포크 줄었다. 하지만 샘플별로 보면 모든 샘플의 손실이 처음부터 줄지는 않는다.
주의할 점 2: 결정 경계 근처의 샘플은 가장 늦게 학습된다
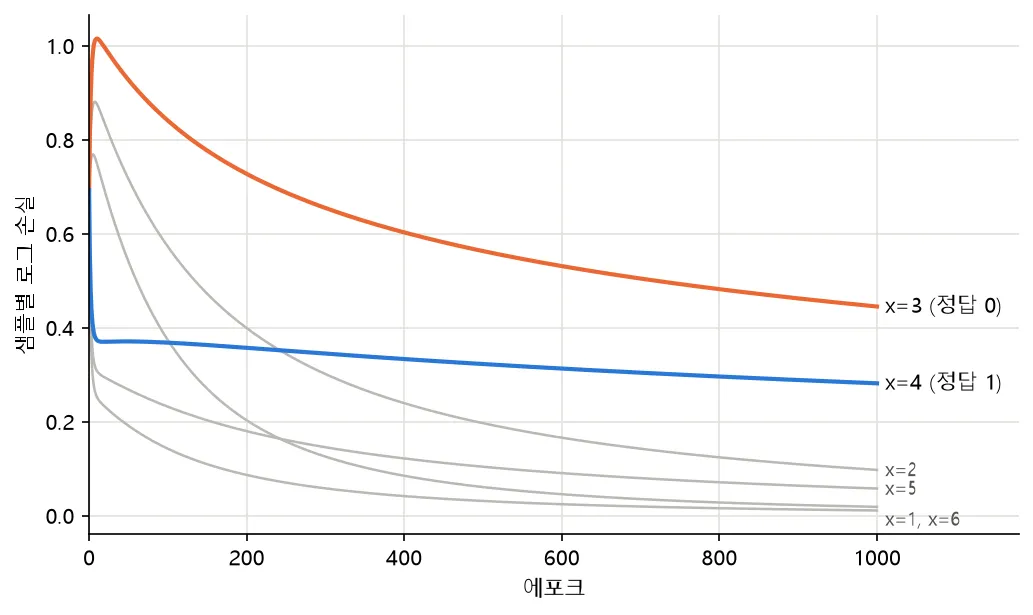
1,000 에포크 뒤 x=1, x=6의 손실은 0.018, 0.011로 거의 0이다. 경계 바로 옆의 x=3은 0.445, x=4는 0.281로 아직 크다. 양 끝 샘플은 분류가 쉽고 경계 근처 샘플이 어렵다는 직관 그대로다.
그래프 왼쪽 끝도 볼 만하다. 정답이 0인 x=1~3의 손실은 처음 몇 에포크 동안 오히려 올랐다. x=3은 10 에포크째 1.015까지 올라갔다가 내려온다. 첫 업데이트에서 w만 양수가 되고 b는 0에 머물러서, 잠시 모든 샘플이 합격 쪽(z > 0)으로 밀렸기 때문이다. b가 충분히 음수가 된 뒤에야 불합격 샘플의 손실이 줄기 시작한다. 평균 손실만 보면 이 과정은 보이지 않는다. 평균 손실로 전체 추세를 보고, 이상하면 샘플별 손실을 열어 본다.
주의할 점 3: 에포크 수는 학습률과 묶어서 정한다
w, b를 한 번에 얼마나 움직일지 정하는 값이 학습률(learning rate)이다. 1편과 이 글은 0.1을 쓴다. 다른 조건(초기값 0, 1,000 에포크)은 그대로 두고 학습률만 바꾸면 다음과 같다.
| 학습률 | 1,000 에포크 후 평균 손실 | w | 결정 경계 -b/w |
학습 정확도 100% 첫 도달 | 손실이 직전보다 늘어난 에포크 수 |
|---|---|---|---|---|---|
| 0.01 | 0.4215 | 0.53 | 2.48 | 1,000 에포크까지 도달 못 함 (83.3%) | 0 |
| 0.1 | 0.1516 | 1.70 | 3.34 | 243 | 0 |
| 0.5 | 0.0642 | 3.22 | 3.45 | 49 | 0 |
| 1.0 | 0.0403 | 4.16 | 3.46 | 8 | 15 |
| 5.0 | 0.0071 | 7.69 | 3.48 | 5 | 57 |
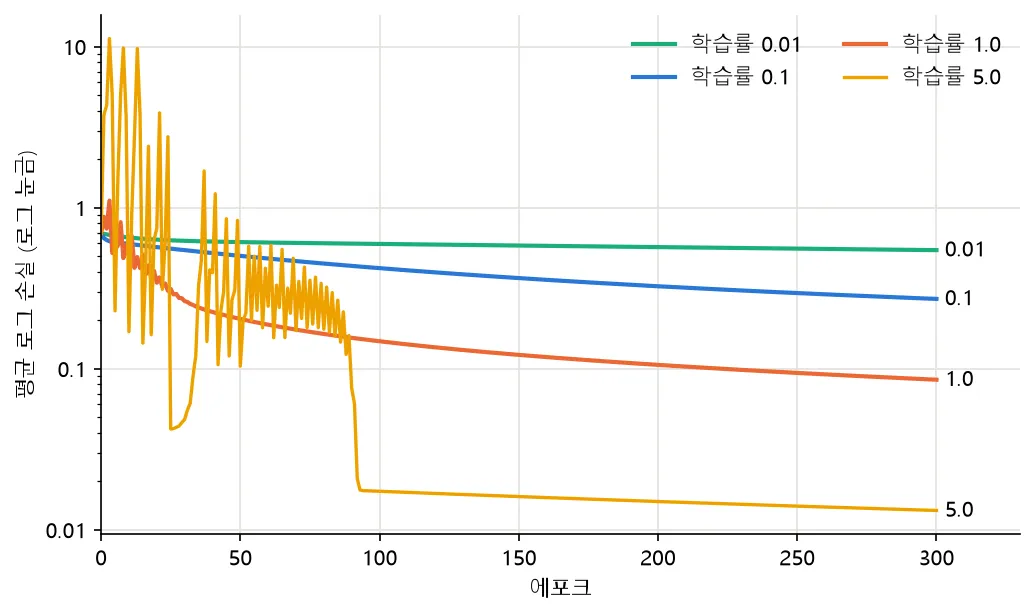
작으면 다 배우지 못한다. 학습률 0.01에서는 1,000 에포크가 지나도 결정 경계가 2.48이다. 3시간 공부한 학생(정답 0)을 여전히 합격으로 분류한다. 1편에서 쓴 “1,000 에포크”는 학습률 0.1과 짝을 이룰 때만 충분한 숫자다.
크면 처음에 출렁인다. 학습률 1.0과 5.0에서는 손실이 줄었다 늘었다를 반복한다. 5.0에서는 3 에포크째 평균 손실이 11.22까지 치솟았고, 89 에포크까지 손실이 늘어나는 구간이 나왔다. 한 번에 너무 멀리 움직여서 손실이 낮은 곳을 지나쳤다가 되돌아오는 것으로 보인다.
그런데 이 데이터에서는 큰 학습률이 결국 더 낮은 손실에 도달했다. 학습률 20과 50에서도 둘 다 11 에포크 이후로는 손실이 다시 늘지 않았고 NaN도 나오지 않았다. “학습률이 크면 발산한다”는 설명을 흔히 보는데, 이 데이터에서는 재현되지 않았다. 내 해석으로는 두 가지 이유가 겹친 것 같다. 첫째, 로그 손실의 기울기는 p - y라서 크기가 1을 넘지 않으니 한 걸음의 크기에 상한이 있다. 둘째, 이 데이터는 완벽히 나뉘어서(3편) w가 커질수록 손실이 계속 줄어드는 방향이 열려 있다. 클래스가 겹치는 데이터에서도 큰 학습률이 괜찮은지는 확인하지 않았다.
큰 학습률은 “더 오래 학습한 것”과 비슷하다. 학습률 1.0으로 1,000 에포크 학습한 결과(w = 4.1622, 경계 3.4629)는 학습률 0.1로 10,000 에포크 학습한 결과(w = 4.1539, 경계 3.4628)와 거의 같다. 학습률을 10배 키우면 같은 길을 10배 빨리 간 셈이다. 이 데이터에서 그 길의 끝은 3편에서 볼 “w가 끝없이 커지는” 방향이다. 학습률 50으로 1,000 에포크를 돌리면 w = 25.83이 되고, x=5, 6의 확률은 float64에서 정확히 1.0이 된다. 앞에서 본 clip이 필요한 상황이 실제로 생긴 것이다.
Footnotes
-
이름에 대해. 이 손실은 교차 엔트로피(cross-entropy), 이진 교차 엔트로피(binary cross-entropy)라고도 부르지만, Google 머신러닝 용어집은 교차 엔트로피를 “로그 손실을 다중 클래스 분류 문제로 일반화한 것”으로 정의하므로 이 글에서는 이진 분류의 이름인 로그 손실로 쓴다. 교차 엔트로피와 로그 손실의 관계. 교차 엔트로피는 정보 이론에서 온 개념이다. 한국어 위키백과는 이를 실제 분포 P 대신 추정한 분포 Q에 맞춘 부호화를 쓸 때 사건 하나를 식별하는 데 드는 평균 비트 수로 설명하고,
H(P, Q) = -E_P[log Q] = -Σ P(x)·log Q(x)로 정의한다. 비트 수로 읽는 것은 밑이 2인 로그를 쓸 때이고, 본문의np.log는 자연로그라 단위가 nat이다. 아래 연결은 로그의 밑을 같게 맞춘 것이다. 이진 분류에서 실제 분포를 정답 쪽에 확률 1을 준P = (y, 1 - y)로, 모델의 예측을Q = (p, 1 - p)로 놓으면H(P, Q) = -( y·log(p) + (1 - y)·log(1 - p) )가 된다. 본문의 로그 손실과 같은 식이다. 클래스가 K개이면 같은 정의에서-Σ y_k·log(p_k)가 나온다. 그래서 교차 엔트로피를 로그 손실의 다중 클래스 일반화라고 부른다. 여기서 P, Q는 본문의 예측 확률 p와 다른 기호다. ↩