로지스틱 회귀 1편: 예측
로지스틱 회귀의 예측 단계(선형식, 시그모이드, 임계값)를 데이터 6개로 실행하고, 단계마다 중요한 점과 주의할 점을 정리했다.
이 글의 코드와 수치는 노트북으로 직접 실행해 볼 수 있다.
노트북 내려받기이름은 회귀인데 하는 일은 분류다
공부시간이 1시간부터 6시간까지인 학생 6명이 있다. 3시간 이하는 불합격(0), 4시간 이상은 합격(1)이다.
| 공부시간 x | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| 합격 여부 y | 0 | 0 | 0 | 1 | 1 | 1 |
이 데이터로 “3.5시간 공부한 학생은 합격할까”를 묻는 문제는 이진 분류(binary classification)다. 로지스틱 회귀(logistic regression)는 이 문제를 푸는 가장 단순한 모델 가운데 하나다. 이름에 ’회귀’가 들어가 있어서 처음엔 헷갈리는데, 숫자를 예측하는 회귀가 아니라 0과 1 중 하나를 고르는 분류 모델이다. 정확히는 먼저 합격 확률을 계산하고, 그 확률을 기준으로 클래스를 정한다.
로지스틱 회귀는 몇 줄의 코드로 구현할 수 있다. 그래서 중간 단계를 건너뛰고도 이해했다고 여기기 쉽다. 이 시리즈는 예측이 만들어지고 모델이 학습되는 과정을 6단계로 나눈다. 단계마다 꼭 알아야 할 것 하나와 틀리기 쉬운 것 하나를 고르고, 그 함정이 위의 6개 데이터에서 실제로 어떻게 드러나는지 보여 준다. 1편은 예측 단계(①~③)를 다룬다.
| 편 | 단계 | 하는 일 |
|---|---|---|
| 1편 예측 | ① 선형식 | z = w·x + b. 범위 제한 없는 점수 |
| 1편 예측 | ② 시그모이드 | p = 1 / (1 + e^(-z)). 0과 1 사이의 확률 |
| 1편 예측 | ③ 임계값 | p ≥ 0.5이면 1. 최종 클래스 |
| 2편 학습 | ④ 로그 손실 | p와 정답 y의 차이를 하나의 숫자로 |
| 2편 학습 | ⑤ 경사 하강법 | 손실이 줄어드는 방향으로 w, b를 조금씩 수정 |
| 3편 학습 종료 | ⑥ 학습 종료 | 언제 멈출 것인가 |
1단계 선형식: z는 확률이 아니라 점수다
한 줄 요약: z = w·x + b는 범위 제한이 없는 점수다. 확률로 읽으면 안 된다.
중요한 것
로지스틱 회귀의 첫 단계는 선형 회귀와 똑같다. 입력 x에 가중치(weight) w를 곱하고 편향(bias) b를 더한다.
z = w·x + b여기서 나온 z는 음수일 수도 있고 100을 넘을 수도 있다. z는 “합격 쪽으로 얼마나 기울었는가”를 나타내는 점수일 뿐 확률이 아니다. 이 점수를 로짓(logit)이라고 부른다. 이름의 유래는 다음 단계에서 확률 p를 만든 뒤 거꾸로 풀어 보면 나온다.
z = log( p / (1 - p) ) ← 확률 p의 로그 오즈(log-odds)즉 로지스틱 회귀는 “로그 오즈가 x에 대해 직선”이라고 가정하는 모델이다. 확률 자체가 직선이라는 가정이 아니다.
주의할 점: 선형 회귀를 그대로 분류에 쓰면 범위를 벗어난다
“0과 1을 숫자로 보고 선형 회귀로 맞춘 다음 0.5를 넘으면 합격으로 하면 되지 않나?” 한 번쯤 떠올리는 방법이다. 위의 6개 데이터에 최소제곱법(OLS)으로 직선을 맞추면 다음과 같다.
w, b = np.polyfit(X, y, 1)
print(w, b)
print(w * X + b)
print(round(w * 10 + b, 6))0.2571428571428571 -0.39999999999999947
[-0.14285714 0.11428571 0.37142857 0.62857143 0.88571429 1.14285714]
2.171429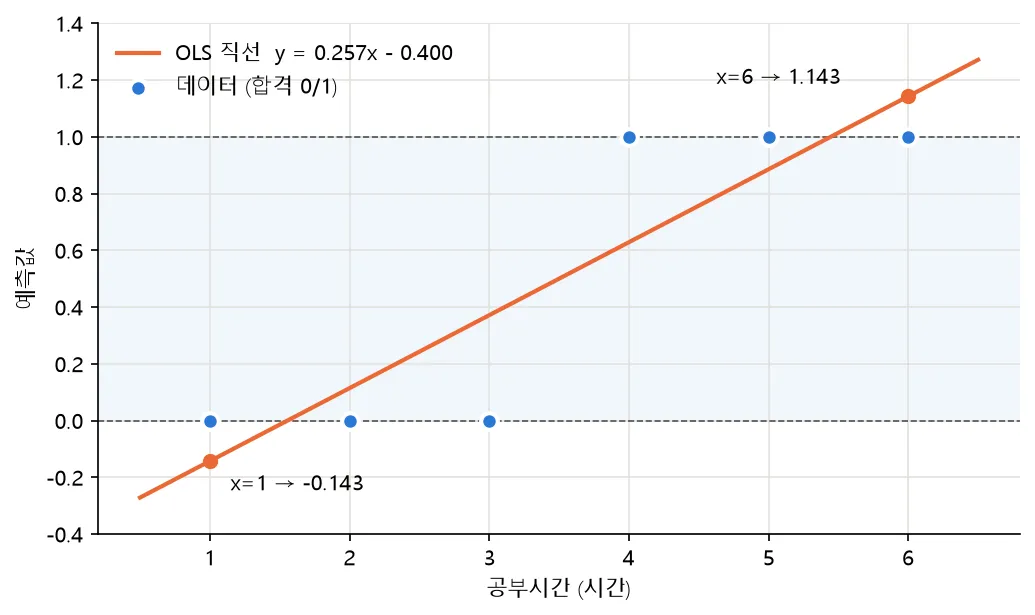
데이터 범위 안인 1시간에서 이미 -0.143, 6시간에서 1.143이 나온다. 10시간을 넣으면 2.171이다. 확률이라면 -14%나 217%는 말이 안 된다. 이 직선을 0.5에서 자르면 이 데이터에서는 분류 자체는 맞는다(경계 약 3.5시간). 하지만 출력을 확률로 해석할 수 없고, 손실을 계산할 때도 이 값을 그대로 쓸 수 없다.
그래서 z를 0과 1 사이로 압축해 줄 함수가 필요하다. 그것이 다음 단계의 시그모이드다.
2단계 시그모이드: 0~1로 압축하지만 양 끝은 평평하다
한 줄 요약: 시그모이드는 어떤 z든 0과 1 사이로 압축한다. z=0일 때 출력은 정확히 0.5이고, 양 끝으로 갈수록 출력이 거의 변하지 않는다.
중요한 것
Google 머신러닝 용어집은 시그모이드 함수(sigmoid function)를 “입력 값을 제한된 범위(일반적으로 01 또는 -1+1)로 ’압축’하는 수학 함수”라고 정의한다. 2나 100만, -10억을 넣어도 출력은 그 범위 안에 있다는 뜻이다. 로지스틱 회귀에서 쓰는 형태는 다음과 같다.
sigmoid(z) = 1 / (1 + e^(-z))몇 가지 z를 넣으면 다음과 같다.
| z | sigmoid(z) |
|---|---|
| -10 | 0.0000454 |
| -3 | 0.0474 |
| -1 | 0.2689 |
| 0 | 0.5 |
| 1 | 0.7311 |
| 3 | 0.9526 |
| 10 | 0.99995 |
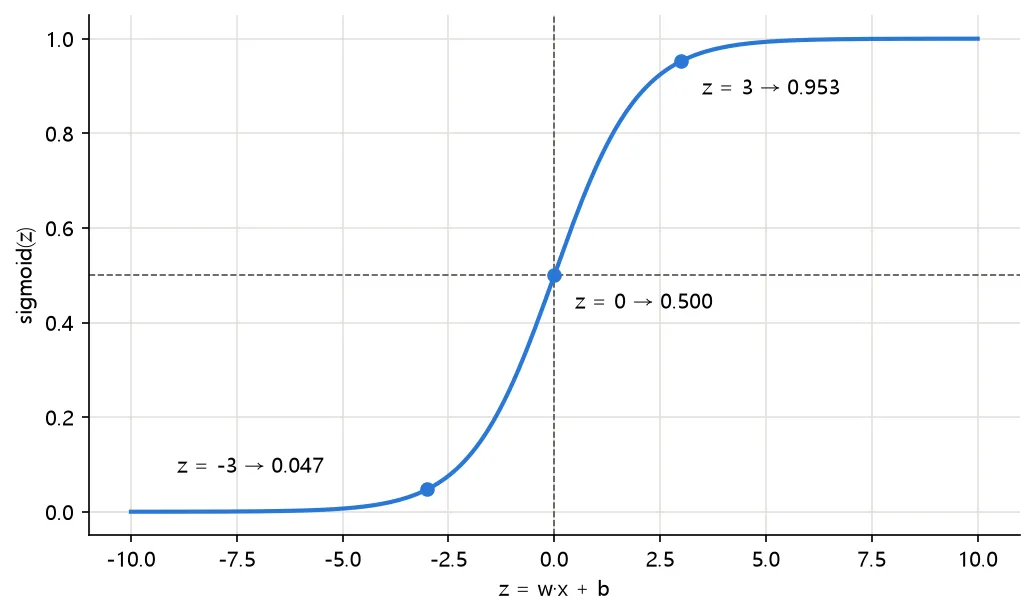
여기서 꼭 기억할 것은 두 가지다.
- 출력은 “0 또는 1”이 아니라 “0과 1 사이”다. 시그모이드가 결과를 0과 1로 바꿔 준다고 이해하면 틀린다. 0이나 1로 자르는 것은 다음 단계인 임계값이 하는 일이다.
- z=0일 때 0.5다. 시그모이드는 단조 증가하므로 “확률 ≥ 0.5”는 “z ≥ 0”과 같은 말이다. 그래서 확률이 0.5가 되는 공부시간, 즉 결정 경계(decision boundary)는
w·x + b = 0을 풀면 바로 나온다.x = -b/w다. 이 식은 3편에서 다시 쓴다.
주의할 점: 양 끝에서는 z가 크게 변해도 출력이 거의 안 변한다
z를 1에서 3으로 바꾸면 출력은 0.7311에서 0.9526으로 0.22 오른다. z를 3에서 10으로 7이나 바꿔도 출력은 0.9526에서 0.99995로 0.047밖에 안 오른다. 그래프 양 끝의 평평한 구간이다.
이 평평함 때문에 두 가지 문제가 생긴다.
- 기울기가 작아진다. 시그모이드의 미분은
p·(1 - p)이다. p=0.5에서 최대 0.25이고, p가 0이나 1에 가까워지면 0에 가까워진다. 이 작은 값이 손실 함수 설계에 큰 영향을 준다(2편). - 컴퓨터에서는 정말로 1이 된다. 수학적으로 시그모이드는 0이나 1에 닿지 않는다. 하지만 float64에서는 z가 37 정도만 돼도 결과가 정확히 1.0이 된다(0.5 간격으로 확인한 값이다).
print(sigmoid(np.array(36.5)) == 1.0)
print(sigmoid(np.array(37.0)) == 1.0)False
True확률이 정확히 1.0이 되면 log(1 - p)가 log(0)이 된다. 2편에서 이때 실제로 inf(무한대)와 NaN(Not a Number)이 나오는 것을 보여 준다.
3단계 임계값: 0.5는 정답이 아니라 관례다
한 줄 요약: 확률을 0이나 1로 바꾸는 임계값은 w, b와 함께 학습되는 값이 아니라 따로 정하는 값이다. 결정 경계 근처의 입력은 모델이 조금만 달라도 판정이 바뀐다.
중요한 것
시그모이드까지 거치면 확률이 나온다. 이 확률을 최종 클래스로 바꾸는 기준이 임계값(classification threshold)이다. 가장 흔한 기준은 0.5다.
proba = np.array([0.82, 0.73, 0.44, 0.12])
predictions = (proba >= 0.5).astype(int)
print(predictions)[1 1 0 0]여기서 짚을 점은 임계값이 w, b와 함께 학습되지 않는다는 것이다. 이 시리즈의 경사 하강법이 찾는 것은 w와 b뿐이고, 임계값은 확률을 어떻게 쓸지에 따라 따로 정한다. 사람이 직접 고를 수도 있고, 검증 데이터의 평가 지표를 기준으로 자동 조정할 수도 있다(scikit-learn의 TunedThresholdClassifierCV 등). 그래서 같은 모델이라도 임계값에 따라 결과가 달라진다. 경사 하강법으로 1,000 에포크 학습한 모델(학습 방법은 2편에서 다룬다)에 몇 가지 공부시간을 넣고 임계값만 바꾸면 다음과 같다.
| 공부시간 | 2.0 | 3.0 | 3.5 | 4.0 | 4.5 |
|---|---|---|---|---|---|
| 합격 확률 | 0.0925 | 0.3591 | 0.5677 | 0.7548 | 0.8782 |
| 임계값 0.3 | 0 | 1 | 1 | 1 | 1 |
| 임계값 0.5 | 0 | 0 | 1 | 1 | 1 |
| 임계값 0.7 | 0 | 0 | 0 | 1 | 1 |
모델은 그대로이고 바뀐 것은 임계값뿐인데, 3시간, 3.5시간 공부한 학생의 판정이 바뀐다.
주의할 점 1: 0.5가 늘 맞는 기준은 아니다
0.5는 “합격으로 잘못 판정하는 비용”과 “불합격으로 잘못 판정하는 비용”이 같을 때 자연스러운 기준이다. Google 머신러닝 단기집중과정도 “0.5가 직관적인 임계값처럼 보이지만, 한쪽 오분류의 비용이 다른 쪽보다 크면 좋은 선택이 아니다”라고 설명한다. 또 임계값을 올리면 모델이 양성(1) 예측을 대체로 덜 하게 되어, 맞는 양성과 틀린 양성이 함께 줄어든다고 한다.
예를 들어 질병 검사처럼 환자를 놓치는 비용이 크면 임계값을 낮춰 양성 판정을 넓힌다. 스팸 필터처럼 정상 메일을 스팸으로 버리는 비용이 크면 임계값을 높인다. 위의 표에서 임계값 0.3과 0.7이 바로 이 두 방향이다.
이 모델을 학습 데이터 6개에 적용하면 임계값 0.3에서는 x=3(확률 0.359)을 합격으로 잘못 분류해 6개 중 5개를 맞히고, 0.5와 0.7에서는 6개를 모두 맞힌다. 하지만 학습에 쓴 데이터로 임계값까지 고르면 그 데이터에만 맞춘 선택이 되기 쉽다. 별도의 검증 데이터와 목적에 맞는 평가 기준 없이 이 결과만으로 새 데이터에 가장 좋은 임계값을 정할 수는 없다. 이 글은 임계값을 고르는 방법(정밀도·재현율 곡선 등)까지는 다루지 않는다.
주의할 점 2: 결정 경계 근처의 판정은 모델마다 갈린다
데이터 한가운데인 3.5시간을 보자. 같은 6개 데이터로 학습한 모델들에서 3.5시간의 합격 확률을 비교했다.
| 모델 | 3.5시간의 합격 확률 | 임계값 0.5 판정 |
|---|---|---|
| 경사 하강법, 1,000 에포크 | 0.5677 | 합격 |
| 경사 하강법, 10,000 에포크 | 0.5386 | 합격 |
| 경사 하강법, 100,000 에포크 | 0.5337 | 합격 |
scikit-learn LogisticRegression 기본값 |
0.50003 | 합격 (0.5를 0.00003 넘음) |
판정은 모두 “합격”이지만 확신의 정도가 다르다. 직접 구현한 모델은 0.57로 꽤 자신 있게 합격이라고 한다. scikit-learn 모델은 사실상 반반이다. 데이터를 보면 3시간까지는 전부 불합격, 4시간부터는 전부 합격이라 3.5시간에 대해서는 데이터가 아무 말도 해 주지 않는다. 내 해석으로는, 데이터가 비워 둔 이 구간을 모델마다 다르게 채운 것이다.
경사 하강법 모델의 결정 경계(-b/w)는 1,000 에포크에서 3.34다. 데이터의 한가운데인 3.5보다 왼쪽이라서 3.5시간이 합격 쪽에 들어간다. 학습을 오래 할수록 경계는 3.46, 3.48로 3.5에 다가간다. 왜 이렇게 되는지는 3편에서 다룬다.