NumPy 5편: 행렬곱
NumPy의 내적과 행렬곱(@), shape 규칙과 곱하는 순서, 점 여러 개를 행렬곱으로 옮기는 방법, 반복문과의 속도 비교를 예제와 실행 결과로 정리했다.
이 글의 코드와 수치는 노트북으로 직접 실행해 볼 수 있다.
노트북 내려받기NumPy에서 내적과 행렬곱을 계산하는 방법, shape 규칙과 곱하는 순서, 행렬곱으로 점 여러 개를 한 번에 옮기는 방법을 정리하고 반복문과 속도를 비교했다. 예제의 출력은 모두 노트북을 실행한 결과다.
한눈에 보기
| 하고 싶은 것 | 코드 | 결과 / 주의 |
|---|---|---|
| 내적 | a @ b, np.dot(a, b) |
같은 자리 곱의 합. 숫자 하나 |
| 행렬곱 | A @ B, np.matmul(A, B) |
(m, n) @ (n, p) = (m, p). 안쪽 크기가 같아야 한다 |
| 곱하는 순서 | A @ B와 B @ A |
결과가 다르다 |
| 1차원 배열과의 곱 | v @ M, M @ v |
결과는 1차원 |
| 점 여러 개 옮기기 | P @ M |
행 하나가 점 하나 |
| 반복문과 속도 비교 | P @ M |
측정 환경에서 97~138배 빨랐다 |
| np.matrix를 쓰지 않는 이유 | np.array + @ |
np.matrix에서는 *가 행렬곱 |
내적
같은 길이의 1차원 배열 두 개를 @로 곱하면 같은 자리끼리 곱해서 모두 더한 값(내적) 하나가 나온다. np.dot도 같다.
a = np.array([1, 2, 3])
b = np.array([4, 5, 6])
print(a * b, (a * b).sum())
print(a @ b, np.dot(a, b))[ 4 10 18] 32
32 32a * b는 같은 자리 곱의 배열이고(4편), a @ b는 그 합이다.
행렬곱
A @ B의 i행 j열은 A의 i행과 B의 j열의 내적이다. 그래서 A의 열 수와 B의 행 수가 같아야 하고, 결과의 shape는 (A의 행 수, B의 열 수)다.
| 방법 | 2차원 배열에서 |
|---|---|
A @ B |
행렬곱 |
np.matmul(A, B) |
@와 같다 |
np.dot(A, B) |
@와 같다 |
A = np.array([[1, 2, 3],
              [4, 5, 6]])        # (2, 3)
B = np.array([[7, 8],
              [9, 10],
              [11, 12]])         # (3, 2)
C = A @ B
print(C)
print(C.shape)
print(np.array_equal(C, np.matmul(A, B)), np.array_equal(C, np.dot(A, B)))
print(A[0] @ B[:, 1])[[ 58 64]
[139 154]]
(2, 2)
True True
64(2, 3) @ (3, 2)의 결과는 (2, 2)다. 0행 1열의 64는 A의 0행 [1, 2, 3]과 B의 1열 [8, 10, 12]의 내적이다(1×8 + 2×10 + 3×12).
try:
    A @ A
except ValueError as e:
    print('ValueError:', e)
try:
    A * B
except ValueError as e:
print('ValueError:', e)ValueError: matmul: Input operand 1 has a mismatch in its core dimension 0, with gufunc signature (n?,k),(k,m?)->(n?,m?) (size 2 is different from 3)
ValueError: operands could not be broadcast together with shapes (2,3) (3,2) (2, 3) @ (2, 3)은 안쪽 크기가 3과 2로 달라서 계산할 수 없다. 첫 에러 문구의 (n?,k),(k,m?)가 “앞 배열의 마지막 축과 뒤 배열의 첫 축이 같아야 한다”는 뜻이다.
같은 모양의 정사각 행렬에서는 *와 @ 모두 에러 없이 계산되고 결과가 다르다.
S = np.array([[1, 2], [3, 4]])
T = np.array([[5, 6], [7, 8]])
print(S * T)
print(S @ T)[[ 5 12]
[21 32]]
[[19 22]
[43 50]]곱하는 순서
행렬곱은 순서를 바꾸면 결과가 달라진다. shape부터 달라질 수 있고, shape가 같아도 값이 다를 수 있다.
print((A @ B).shape, (B @ A).shape)

X = np.array([[1, 2], [3, 4]])
Y = np.array([[0, 1], [1, 0]])
print(X @ Y)
print(Y @ X)(2, 2) (3, 3)
[[2 1]
[4 3]]
[[3 4]
[1 2]]X @ Y는 X의 두 열을 바꿨고, Y @ X는 X의 두 행을 바꿨다.
1차원 배열과의 곱
1차원 배열이 앞에 오면 행 하나처럼, 뒤에 오면 열 하나처럼 계산되고, 결과도 1차원이다.
| 계산 | shape | 결과 |
|---|---|---|
v @ B |
(3,) @ (3, 2) |
(2,) |
A @ v |
(2, 3) @ (3,) |
(2,) |
w @ A |
(2,) @ (2, 3) |
(3,) |
v = np.array([1, 0, 1])   # (3,)
w = np.array([1, 1])      # (2,)
print(v @ B, (v @ B).shape)
print(A @ v, (A @ v).shape)
print(w @ A, (w @ A).shape)[18 20] (2,)
[ 4 10] (2,)
[5 7 9] (3,)v @ B는 B의 0행과 2행을 더한 것이고, w @ A는 A의 두 행을 더한 것이다.
점 여러 개를 한 번에 옮기기
점 N개의 좌표를 행으로 쌓은 (N, 2) 배열 P에 (2, 2) 행렬 M을 곱하면 모든 점이 한 번에 옮겨진다. 점 (x, y)는 (x·M[0,0] + y·M[1,0], x·M[0,1] + y·M[1,1])로 간다.
P = np.array([[0, 0],
              [1, 0],
              [1, 1],
              [0, 1]], dtype=float)   # 점 4개, 행 하나가 점 하나 (x, y)
scale = np.array([[2, 0],
                  [0, 1]])
rotate = np.array([[0, 1],
                   [-1, 0]])
shear = np.array([[1, 0],
                  [0.5, 1]])
for name, M in [('scale', scale), ('rotate', rotate), ('shear', shear)]:
print(name, (P @ M).tolist())scale [[0.0, 0.0], [2.0, 0.0], [2.0, 1.0], [0.0, 1.0]]
rotate [[0.0, 0.0], [0.0, 1.0], [-1.0, 1.0], [-1.0, 0.0]]
shear [[0.0, 0.0], [1.0, 0.0], [1.5, 1.0], [0.5, 1.0]]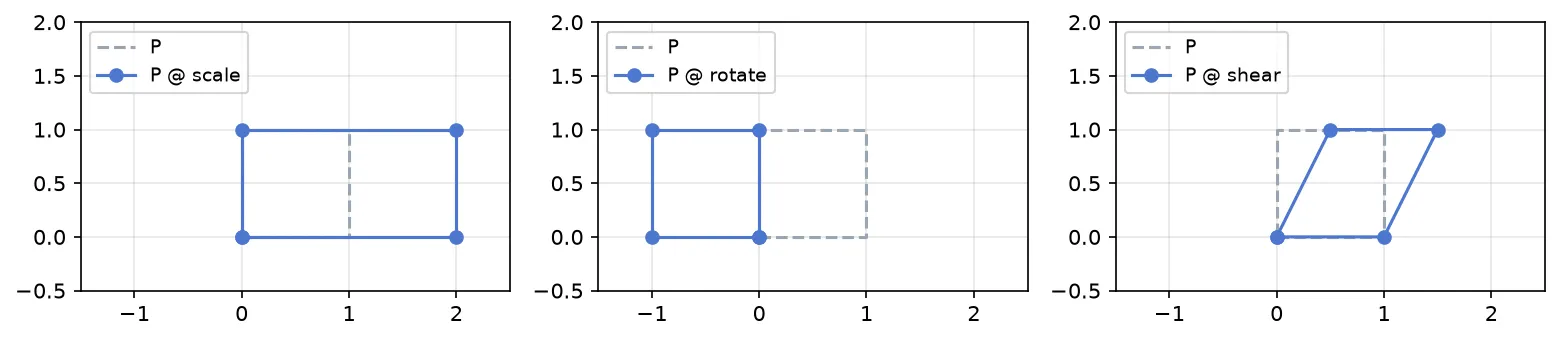
| 행렬 | 결과 |
|---|---|
scale [[2, 0], [0, 1]] |
가로 2배 |
rotate [[0, 1], [-1, 0]] |
반시계 방향 90° 회전 |
shear [[1, 0], [0.5, 1]] |
높이에 비례해 오른쪽으로 밀림 |
반복문과 속도 비교
같은 변환을 파이썬 반복문으로 점마다 계산한 것과 P @ M 한 번으로 계산한 것의 시간을 비교했다. 반복문은 점 좌표를 파이썬 리스트(P.tolist())로 바꿔 돌았고, 점 개수마다 5번 재서 중앙값을 썼다. 두 방식의 결과가 같은지는 np.allclose로 확인했다. 측정 코드는 노트북의 “반복문과 속도 비교” 셀에 있다.
| 점 개수 | 반복문 | P @ M |
@가 빠른 정도 |
|---|---|---|---|
| 1,000 | 0.49 ms | 0.004 ms | 128배 |
| 100,000 | 53.61 ms | 0.555 ms | 97배 |
| 1,000,000 | 536.29 ms | 3.886 ms | 138배 |
측정 환경(Intel Core i5-14450HX, 메모리 16GB, Windows 11)에서 @가 반복문보다 97~138배 빨랐다. 점 100만 개를 옮기는 데 반복문은 약 0.54초, @는 약 3.9밀리초가 걸렸다. 시간은 컴퓨터와 실행할 때마다 달라지므로, 노트북을 직접 실행하면 다른 값이 나온다.
np.matrix를 쓰지 않는 이유
np.matrix는 2차원 전용 클래스로, *가 행렬곱이다. 같은 값으로 만든 np.array에서는 *가 같은 자리 곱이고 행렬곱은 @다.
import warnings
print([f[0] for f in warnings.filters if f[2] is PendingDeprecationWarning])

with warnings.catch_warnings(record=True) as caught:
    warnings.simplefilter('always')
    mm = np.matrix([[1, 2], [3, 4]])
print(caught[0].category.__name__)

aa = np.array([[1, 2], [3, 4]])
print(mm * mm)
print(aa * aa)
print(aa @ aa)['ignore']
PendingDeprecationWarning
[[ 7 10]
[15 22]]
[[ 1 4]
[ 9 16]]
[[ 7 10]
[15 22]]np.matrix를 만들면 PendingDeprecationWarning이 발생하지만, Python의 기본 경고 필터가 이 종류를 무시(ignore)하므로 평소에는 보이지 않는다. 위 코드는 필터를 always로 바꿔 경고를 붙잡았다. NumPy 문서는 이 클래스를 “선형대수에서도 더 이상 권장하지 않는다. 일반 배열을 쓰라”고 적는다(NumPy 문서: numpy.matrix).
시리즈 정리
| 편 | 핵심 |
|---|---|
| 1 만들기 | 무엇이든 shape와 dtype부터 찍는다. 모양은 튜플, arange·integers는 끝 값을 뺀다 |
| 2 인덱싱 | [행, 열]로 꺼내고, 번호 하나로 꺼내면 축이 사라진다. 슬라이스는 뷰, 마스크는 복사본 |
| 3 모양 바꾸기 | reshape는 원소를 다시 채우고, 축 순서는 transpose로 바꾼다. 새 축으로 쌓으면 stack |
| 4 브로드캐스팅과 axis | 뒤 축부터 같거나 1이면 계산된다. axis=k는 k번 축이 사라지고, 다시 계산하려면 keepdims |
| 5 행렬곱 | *는 같은 자리 곱, @는 행렬곱. 안쪽 크기가 같아야 하고 순서를 바꾸면 결과가 다르다 |